地址核查
USDT 被标记成高风险,这个结论是怎么来的
链上只有地址和转账记录,没有名字。那些「高风险」「与某案关联」的标签是谁贴的?这篇讲标签的四类来源、账户型链上真正用的聚类信号、为什么从交易所提币的正常用户也会被误伤,以及已经被标成高风险之后——能洗掉吗,该找谁。
你查一个地址,工具返回"高风险"或者"与某诈骗案关联"。这个结论是怎么来的?链上只有一串地址和转账记录,没有名字,没有身份,那些标签是谁贴的?
搞清楚这套机制有实际用处:你会知道什么情况下结论可信,什么情况下是误伤,以及你自己的哪些习惯会让地址被贴上不该有的标签。
标签的四个来源
交易所和项目方自己公开的。交易所会公布或者向数据商提供自己的充提热钱包地址,项目方会公布金库地址。这类标签准确度最高,因为是当事方自己声明的。
第二类是被盗方公布的。项目被黑之后,团队通常会公开攻击者地址,请求交易所协助拦截。这类标签也比较可靠。
第三类是执法机关公告的。起诉书、制裁名单、案件通报里会列出涉案地址。这是最权威的一类,也是发行方在链上执行拉黑的主要依据。
第四类是算法推断的。这一类量最大,也是误差的主要来源。数据商用启发式规则把地址聚成簇,判断哪些地址属于同一个主体,再把已知标签扩散到整簇。
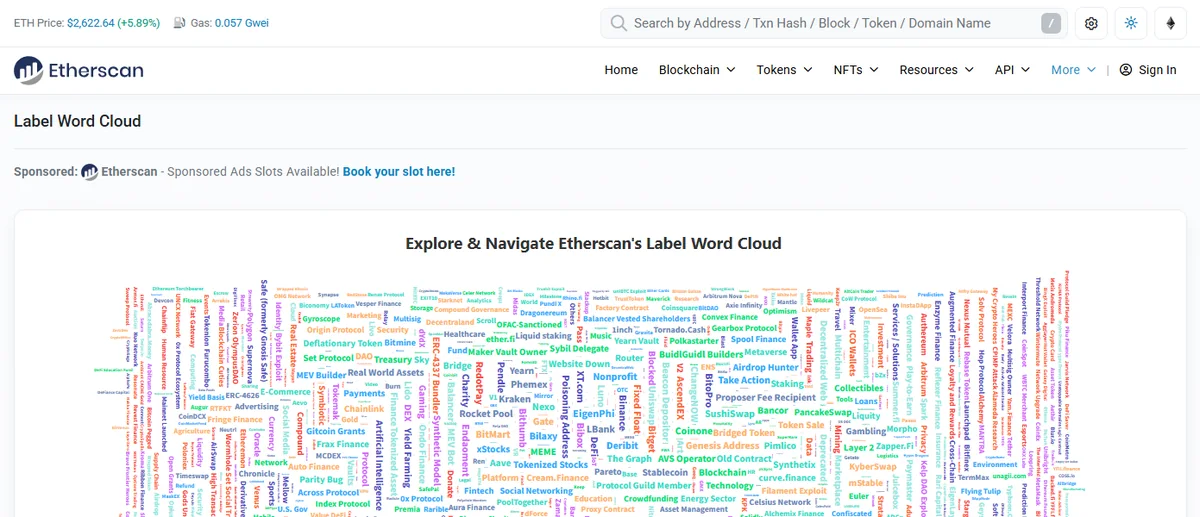
公开标签能有多细,看一眼 Etherscan 的标签云就知道:
词云里每个词都是一类地址标记,后面的数字是归入该标签的地址数。
这个页面公开的规模,2026 年 9 月 19 日数了一下:1310 个带计数的标签分类。随手挑几个看粒度:
| 标签 | 归入的地址数 |
|---|---|
| Aave | 662(其中合约账户 467、代币 195) |
| 0x Protocol | 75(账户 74、代币 1) |
| 1inch | 67(账户 61、代币 6) |
| 0xSplits | 5 |
注意它连"某个协议名下有多少个地址、其中多少是合约多少是代币"都分得清。而这只是一个区块链浏览器免费公开的部分——风控数据商手里的库要大得多,而且包含大量不会公开的涉案地址标记。
这个数字有个直接的用处:当工具告诉你"这个地址属于某交易所"时,它多半来自这类标签库,可信度较高;而当它说"这个地址与某案有关"时,来源往往是不公开的库,你没法复核,只能看它给不给依据。
算法是怎么推断的
先排除一个常见误解。讲链上分析的资料里最常被引用的规则叫"共同输入"——一笔交易同时花掉多个地址里的钱,说明这些地址由同一个人控制。这条规则属于比特币那类 UTXO 账本,在以太坊和波场上不存在,因为这两条链是账户模型,一笔转账只有一个发起地址,没有"多个输入"这回事。你的 USDT 跑在以太坊或波场上,所以共同输入和它的衍生规则(找零识别之类)都和你无关。
账户型链上真正用的信号是另外几类:
-
交易所充值地址复用。你在某家交易所的充值地址是专属的,只要你往它转过一次钱,这个地址和你的其他地址就建立了关联。多个地址向同一个充值地址转账,是判定同属一人的强信号。
-
手续费供给关系。你新建一个地址,要转 USDT 就得先给它一点 ETH 或 TRX。这笔 gas 通常来自你的主地址,于是主地址和新地址之间留下了一条明确的资金关系。这是账户型链上最容易暴露地址归属的动作,也是很多人以为"新地址是干净的"却被关联上的原因。
-
授权对象相同。你给某个合约做过
approve授权,授权记录是公开的。多个地址授权给同一批不常见的合约,形成可识别的指纹。 -
合约交互模式。用哪些协议、按什么顺序、什么时间段活动,这些行为特征组合起来有区分度。
-
时间与金额的关联。A 地址收到一笔钱,几分钟后 B 地址转出几乎相同的金额,这种前后呼应会被当作同一主体或同一资金流的证据。
问题在于这些信号都是概率性的。交易所的批量提现、多人共用的托管钱包、代付 gas 的服务,都会让不相关的地址被聚到一簇。一旦簇里有一个地址带了坏标签,整簇都可能被牵连。
风险分是怎么算出来的
评分的核心逻辑是顺着转账关系往上游追,看钱从哪来,中途碰到过什么。
主要有几种传播模型:
-
按比例分摊:一个地址收到的钱如果有三成来自被标记的来源,那么它的余额里有三成被视为有污点,往下传的时候也按这个比例算。
-
整笔污染:只要碰到过被标记的资金,整个余额都算有污点。这种模型最严格,几跳之后会把大量正常地址卷进来。
-
先进先出:按时间顺序把收到和转出的资金一一对应,判断你转出的那笔具体对应哪笔收入。
除了传播比例,评分还会看跳数。直接从被标记地址收钱,和隔了五跳才间接沾上,风险等级完全不同。多数工具会给出"第几跳碰到什么"这样的信息,这比单独一个分数有用得多。
另外几类会显著拉高评分的特征:资金经过混币服务、地址有大量小额分散转出的模式、与暗网市场或赌博站点收款地址有往来、短时间内高频进出。
为什么正常用户会被误伤
最常见的一种:你从交易所提币到自己钱包。交易所热钱包每天混合成千上万人的资金,里面必然包含一部分后来被认定有问题的钱。如果溯源模型对交易所热钱包这类大型混合节点处理得粗糙,那么任何从交易所提出来的资金,往上追一跳都会"接触过高风险地址"。
成熟的数据商会把交易所热钱包识别为服务型节点,在这里截断溯源,不把它上游的污点继续往下传。但不是所有工具都做得好,这也是不同工具对同一地址给出不同结论的重要原因。
另外几种容易被误伤的情况:
- 你的地址被别人用来做过路中转,比如你把地址给了别人代收,对方又转给了第三方
- 你参与过某个后来被认定有问题的项目,或者用过某个后来被制裁的服务
- 你长期用同一个地址收所有款项,其中任何一笔来源有问题,都会挂在这个地址上
这些标签对你有什么实际影响
要分清两件事:链上黑名单和风控标签,后果完全不同。
链上黑名单是硬的。地址进了 USDT 合约的黑名单,这个地址上的 USDT 就是转不出去,没有任何变通空间。这个状态任何人都能免费查,方法写在"USDT 冻结查询"。
风控标签是软的,它影响的是别人怎么对待你。交易所看到评分偏高,可能要求你补充资金来源材料、限制提币、延长审核,极端情况下限制账户。支付机构和 OTC 商家可能直接拒绝和你交易。
但风控标签不会让你的链上资产动不了。你的 U 还在,还能在链上自由转移,只是进入需要合规审查的入口时会遇到摩擦。
怎么减少被误伤
-
地址分用。不同用途用不同地址:主要资产存放一个、日常小额一个、收陌生款项每次新建一个。这是成本最低、效果最明显的做法,具体做法写在"收款前后要做的核查"。
-
别当过路账户。不要帮别人代收代转,不管对方理由多合理,报酬多高。你的地址成了别人资金链条中的一环,对方的问题就成了你的问题。
-
留好来源记录。大额资金的来源凭证留着。评分只是启动审查的触发器,能不能过关看你能不能说明来源。
-
从交易所提币后别立刻并账。给资金一点独立的时间和路径,不要提出来就立刻汇总到一个大地址里。
-
定期查一次自己的地址。定期用免费额度查一次自己常用地址的评分,异常时你能早知道,而不是等到提币被拦才发现。各类工具分别能查到什么,写在"USDT 地址风险查询"。
已经被标成高风险了,能洗掉吗
先给结论:你没法删除这个标签,能做的是让它不影响你。 这两件事差别很大,搞混了会白费很多力气。
为什么删不掉
风险评分不是某个机构给你颁发的证书,而是各家数据商各自算出来的结论。它们的库不互通,算法也不一样,同一个地址在不同工具里评分可能差很远。而且主流的几家(Chainalysis、TRM、Elliptic)只做机构生意,根本没有面向个人的申诉入口,你连提交材料的地方都找不到。
申诉对象不是数据商,是卡住你的那一方
真正影响你的从来不是那个分数本身,而是交易所拿它做了什么决定。所以要沟通的是交易所的合规工单,不是去追着数据商解释。材料怎么组织成一个能自证的闭环,写在"交易所提币被冻结"。
标签的影响会随时间稀释
评分很大程度取决于"最近几跳碰到了什么"。一个地址如果之后长期只有正常往来,那笔旧关联在多数模型里的权重会逐渐下降。这不是"洗白",是自然衰减——前提是你别再去碰新的可疑资金。
有一种情况它不会稀释:你的地址被明确标成了某个已知案件的关联地址,而不是算法推断的边缘案例。这种标签来自执法公告或当事方声明,属于事实记录,不会因为时间过去就消失。
这几件事明确没用,别做:
换个新地址把钱转过去。溯源会顺着转账关系跟到新地址,而且"资金从被标记地址转出到新地址"这个动作本身就是风控模型的重点特征,做完评分只会更难看。
把钱换成别的币再换回来、过一遍去中心化交易所、拆成小额分散转——同理,全都留痕,而且都是加分项(给风险分加分)。
找人"付费洗白"。链上没有任何东西可以被删除或修改,这类服务卖的是不存在的能力。
唯一真正有用的动作是保留能说明资金来源的完整凭证,以及从现在起不再让这个地址接触来路不明的钱。等到需要解释的时候,拿得出闭环凭证的人和拿不出的人,结果完全不同。
结论可信度怎么判断
看一个风险评估结论时,关心这几点比关心那个分数更有用:
标签是哪一类来源。执法公告和当事方声明可信,算法推断的簇归属要保留怀疑。
跳数是多少。一跳之内有说服力,五跳之外参考价值很低。
中间有没有经过交易所热钱包这类混合节点。如果污点是穿过热钱包传下来的,这个结论基本不用当真。
同一个地址在两三个不同工具里的结论是否一致。差异很大说明这是算法推断的边缘案例,不是确定事实。
四条都指向同一个方向,那个分数才值得当回事。只占一两条的高分,更可能说明你撞上了聚类误差,而不是撞上了脏钱——这两者对你的后果差得很远:前者你解释得清,后者你解释不清。